Proyecto de trabajo
Plataforma de observabilidad
Métricas, logs, trazas, sondas y alertas para más de 20 servicios
El stack que vigila los servicios de integración y los servidores donde corren, con métricas, logs, trazas, sondas y alertas en un mismo lugar.
De qué se trata
Con más de 20 servicios de integración en producción, necesitaba enterarme cuando alguno fallara sin esperar a que un equipo lo reportara. Este repositorio reúne todo lo necesario para eso, desde qué se mide y dónde se guarda hasta cómo se ve y a quién le avisa.
Lo construí en junio de 2026 y corre junto a los servicios que vigila.
Qué hace
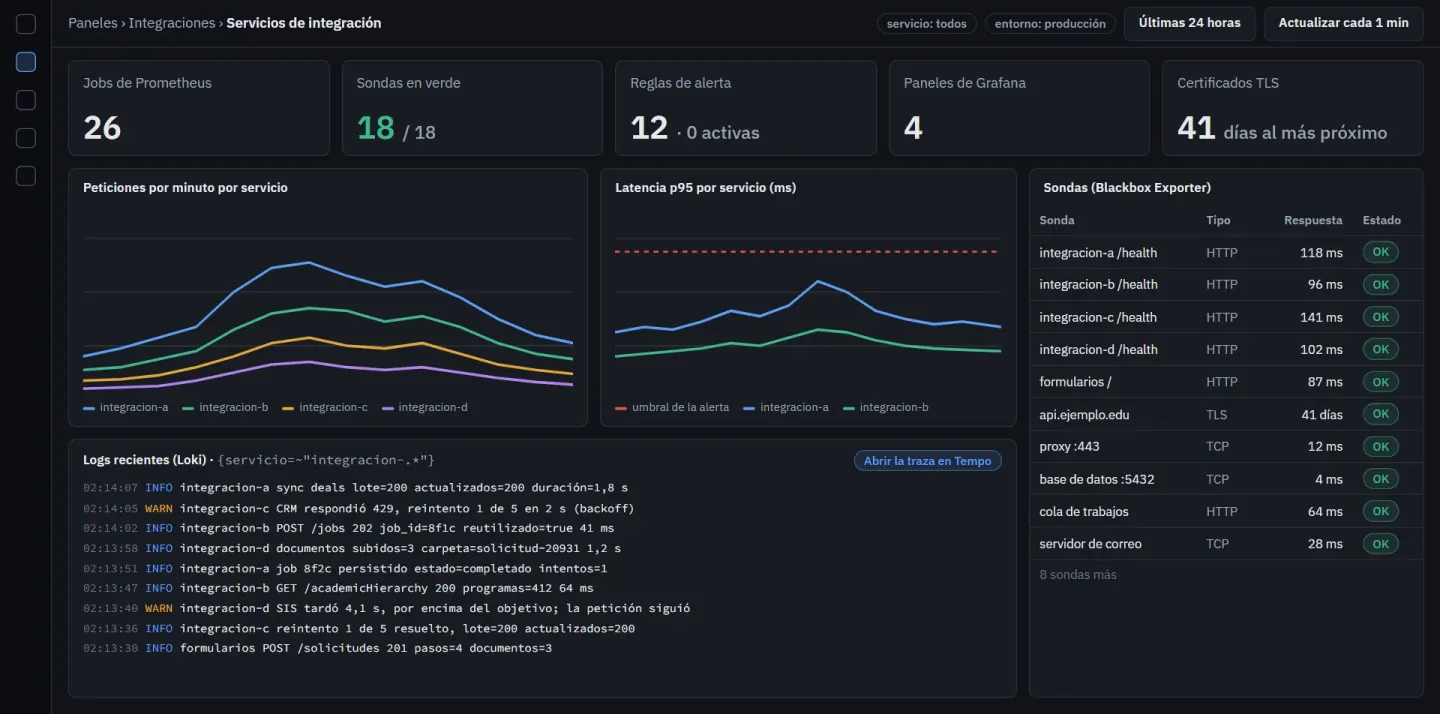
- Prometheus recoge 26 jobs entre los servicios en FastAPI instrumentados, los contenedores con cAdvisor, las máquinas con Node Exporter y Nginx con su exportador.
- 18 sondas de Blackbox Exporter revisan desde afuera que cada servicio y cada dominio respondan, y que sus certificados TLS no estén por vencer.
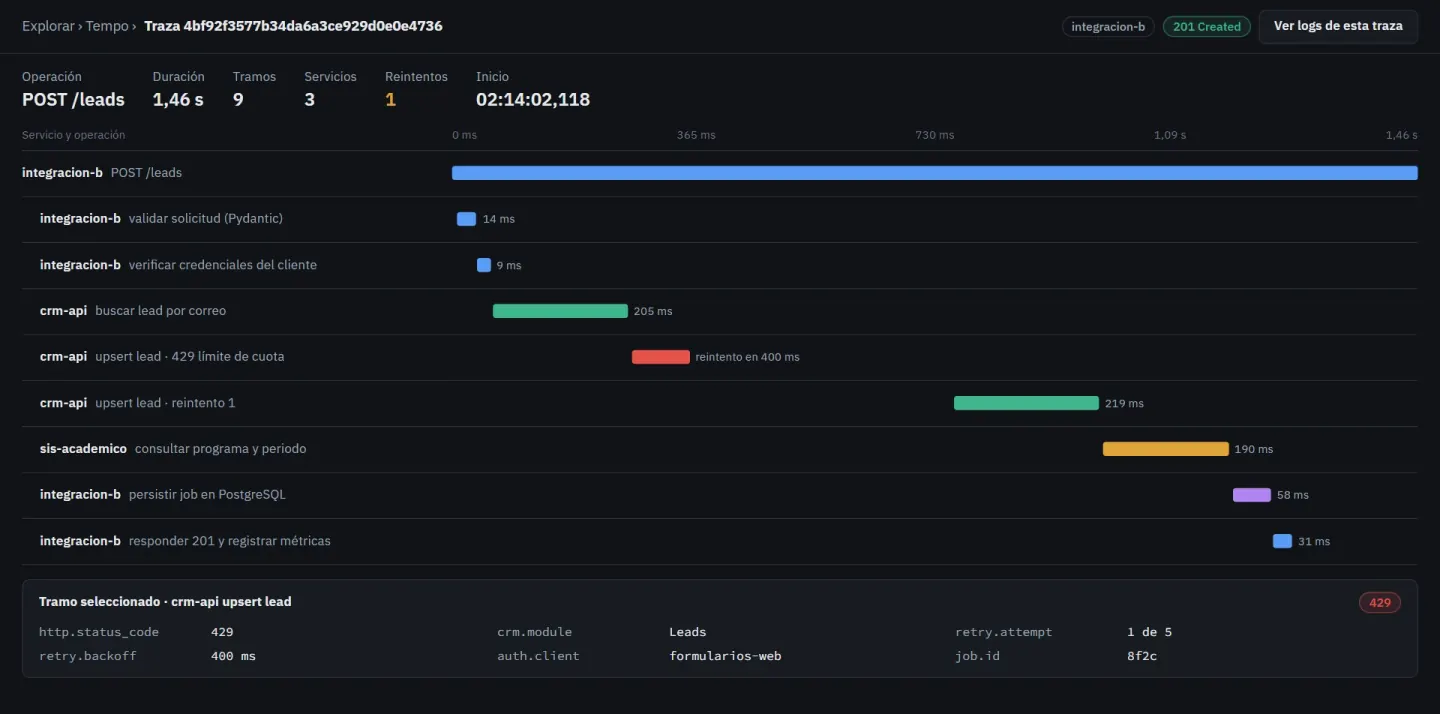
- Promtail lleva los logs de los contenedores a Loki a través de un proxy de solo lectura del socket de Docker, y Tempo recibe las trazas de OpenTelemetry de los servicios.
- Grafana reúne 4 tableros (Docker, FastAPI, máquina y Nginx) y 12 reglas de alerta, entre ellas errores 500 en las integraciones, contenedores que reinician en bucle, disco y CPU, que llegan a Telegram.
- Todo corre en Docker Compose junto a los servicios, con 15 días de retención en Prometheus.
Cómo funciona
De la señal al aviso
Las señales van de izquierda a derecha; la fila de abajo es cómo corre el stack.
Qué se vigila
- Servicios en FastAPI instrumentados
- Sondas de Blackbox Exporter
- Contenedores, máquinas y Nginx
Recolección
- Prometheus con 26 jobs
- Loki con Promtail
- Tempo con OpenTelemetry
Quién se entera
- 4 tableros de Grafana
- 12 reglas de alerta
- Avisos en Telegram
Operación
- Docker Compose junto a los servicios
- Proxy de solo lectura del socket de Docker
- 15 días de retención
Decisiones y sus costos
Sondas desde afuera además de métricas desde adentro
Las métricas de un servicio no dicen nada si el servicio está caído o su dominio no responde.
El socket de Docker detrás de un proxy
Promtail necesita descubrir los contenedores, pero el socket de Docker completo le daría control sobre el servidor.
Alertas a Telegram
Las alertas tenían que llegar al teléfono sin pagar un servicio de guardias.
Stack
Elige una tecnología para ver qué proyectos la usan.


